⟳ WORK IS RUNNING
装上以后,
它会怎么工作?
WORK 不是聊天。它是分步骤推进、最后输出可用结果的工程化工作流。每个步骤都明确,输入不足会主动追问,输出是结构化整案。
- → 三大死因写进机器:抄书(12 字连撞强检)/ 无靶(三色定靶)/ 无闭环(自测答案分离)——笔记质量从「抄没抄全」变成「背没背住」
- → 知识形态判定放第二步:链条型用表格压会断链、并列型顺序写会注水——判错形态整本笔记作废
- → 讲义配图一律裁原图并标注页码,禁止 AI 手绘重画——重画的图和原文对不上,背了反而错
- → 答案全部压到文末:答案跟着题走,等于没自测
- → 实测:813 页真实教材第 3.1 节端到端跑通,退出码 0;坏稿示范被 10 项硬伤全拦——脚本自身首跑修正 4 处也留了痕
USER
考研专业课第三章还有 40 页没整,10 月了还在抄书,帮我把 3.1 节先整出来,能做题那档。
WORK / RUNNING
收到,正在按以下步骤推进:
- ✓ 称书 · 先量再动笔:页数 / 小节数 / 公式密度 / 图数报给你,和你对好档位(过一遍 / 能做题 / 能讲给别人)
- ✓ 立骨 · 判定知识形态:链条型(顺序走+回链)/ 并列型(表格压)/ 流程型(步骤+做错的后果)——判错了整本笔记都废
- ✓ 定靶 · 每节标【必背】/【要懂】/【可跳】:编号公式定义必背,背景故事可跳,拿不准标要懂——全节必背说明范围切小了
- ✓ 写人话 · 每条知识过「合上书测试」:因果句重写,连续 12 字与原文重合=抄书,直接打回;配图一律裁原图禁手绘
- ◐ 闭环节 · 每节 3 道自测(回忆/应用/易错),答案压文末;文末术语表 + 错题回填表,第二轮复习有地图
- ○ 机器自检 · 12 项:靶标齐全 / 答案对号 / 术语表覆盖 / 公式成对 / 12 字抄书红线 / 必背是人话等,退出码 0 才交
OUTPUT READY · 全靶定稿笔记 1 份(8 节 · 约 4,400 字 · 24 题自测)· 术语表 18 条 · 错题回填表 · 12 项自检报告(退出码 0)· 坏稿拦截演示
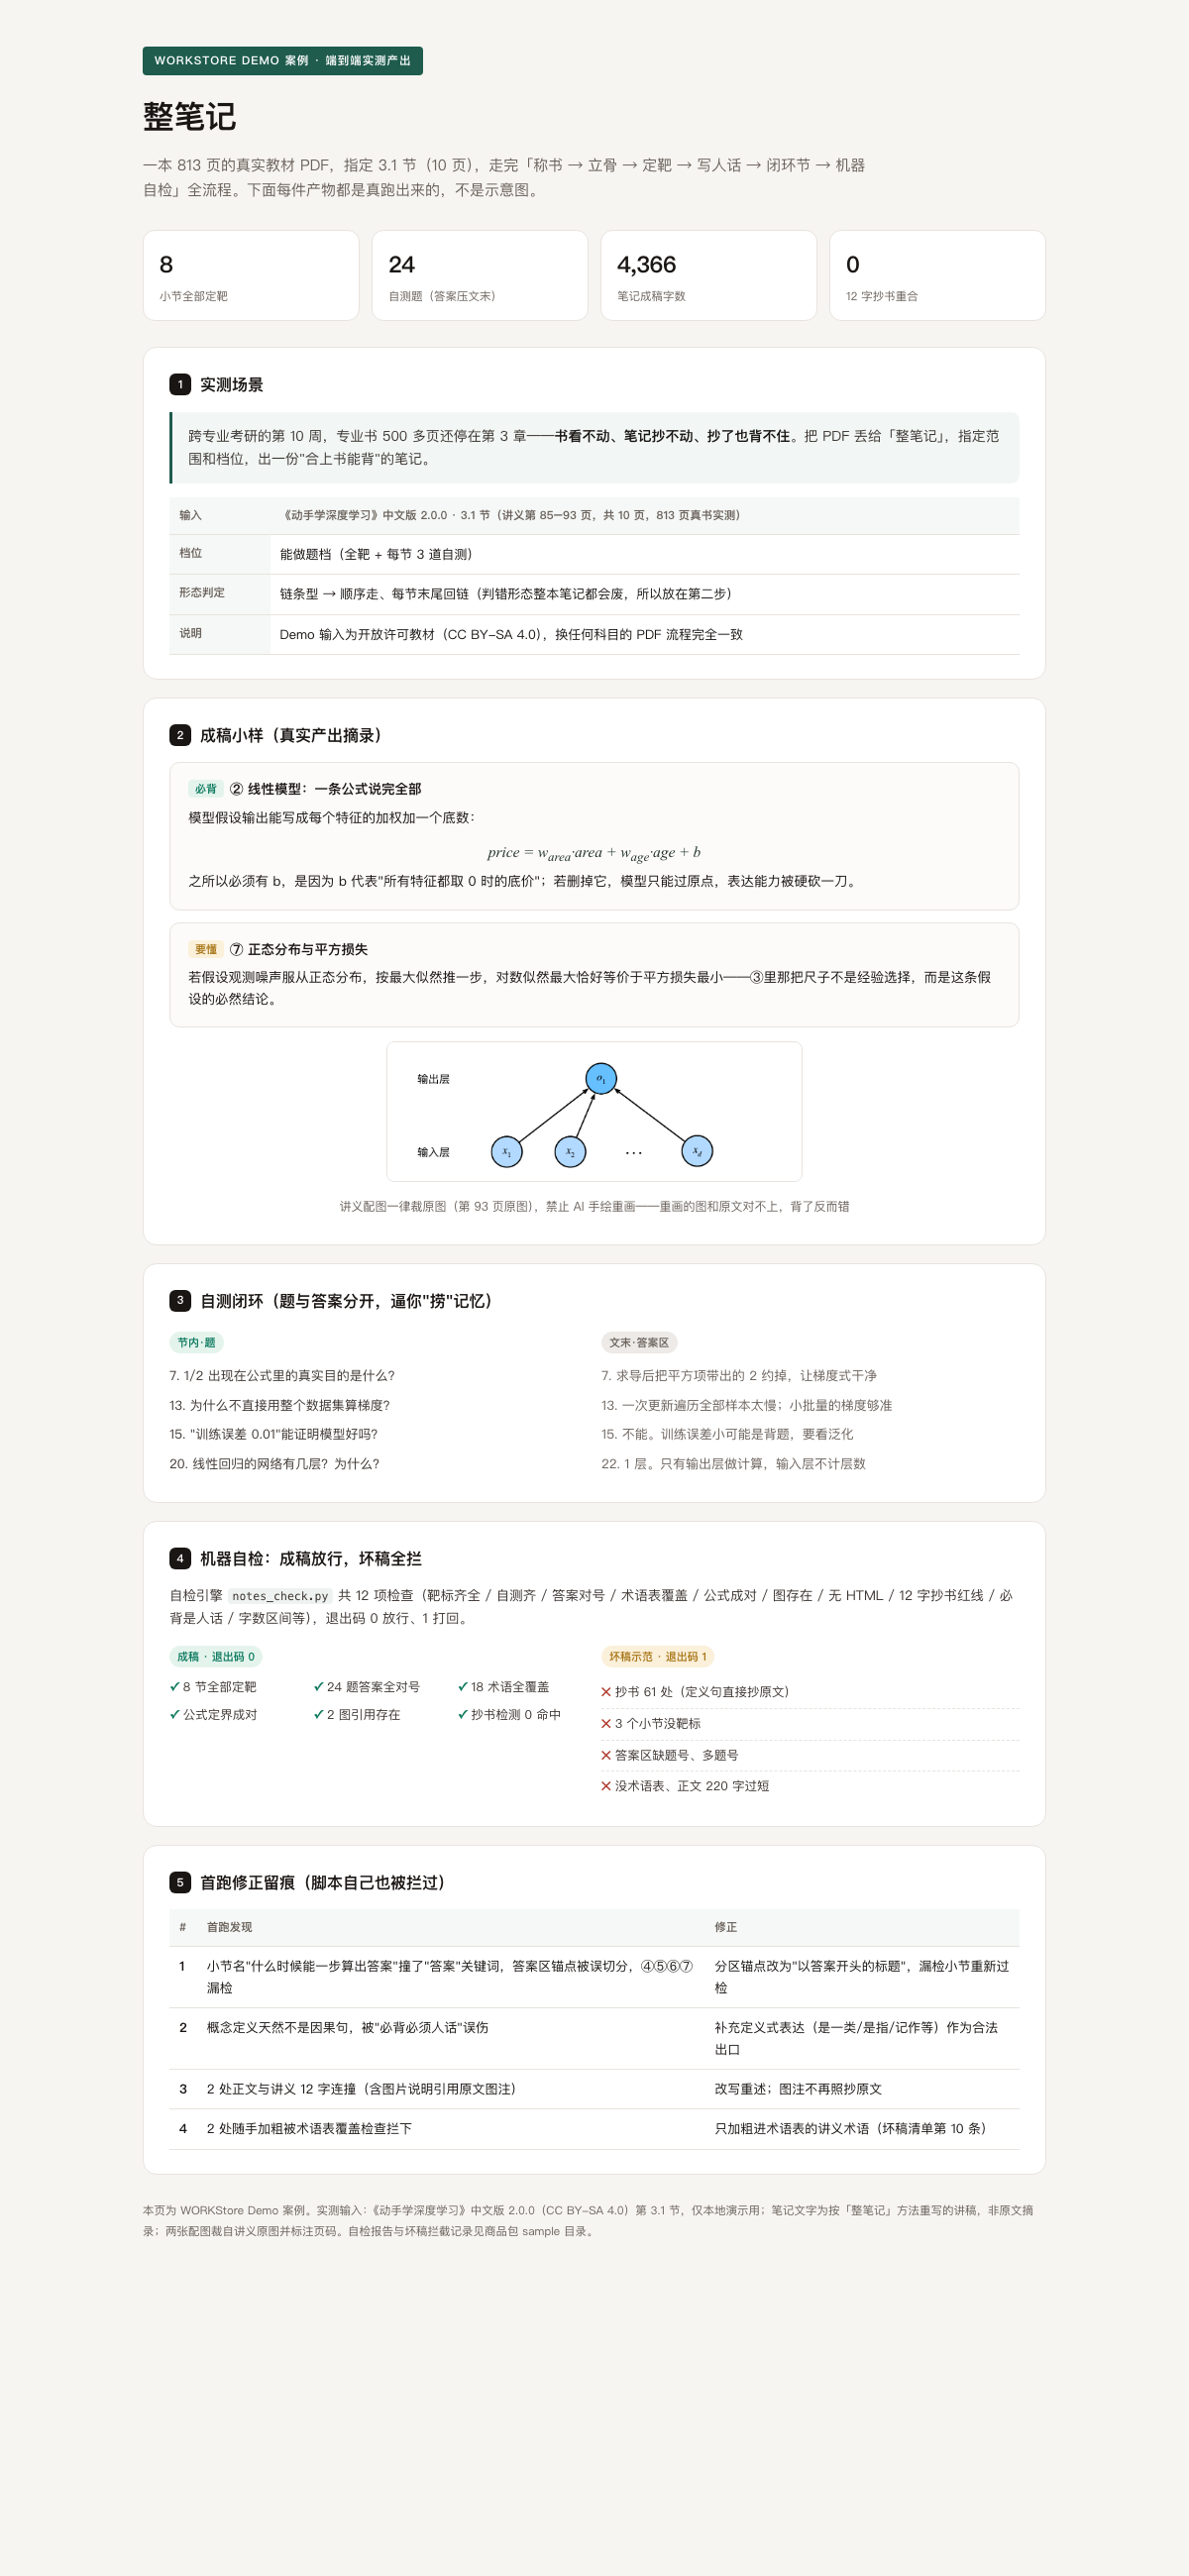
↑ 实机渲染的真实交付物(Demo 用模拟信息,来源已标注)